

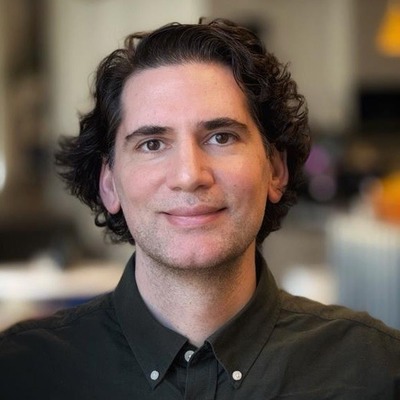
13 år i yrket · Egenföretagare
Hany Ibrahim
Data Engineer / Tech Lead
- Kvadrat Tech Stockholm
Hany har en unik förmåga att omvandla komplexa affärskrav till effektiva tekniska lösningar. Han har lång erfarenhet inom Analytics med tyngdpunkt på lösningsarkitektur, SQL, Python, ETL-utveckling och arkitektur för stora datamängder i molnet i plattformar som Azure Databricks och Google Cloud Platform. Hany är van att arbeta i gränslandet mellan data, teknik och verksamhet, där lösningarna behöver fungera i praktiken och ge konkret stöd i beslutsfattandet.
Han är tekniskt… mycket stark men pratar samma språk som verksamheten och navigerar vant i komplexa miljöer. Som person är Hany organiserad, proaktiv och hjälpsam; han delar gärna med sig av sin kunskap och lägger stor vikt vid att förstå och uppfylla kundens specifika behov. Hany arbetar även med modernisering och vidareutveckling av analytics-miljöer, inklusive praktiska POC:er för AI-baserade lösningar.
Visa merVisa mindre
- Google Cloud Platform
- Databricks
- Azure Databricks
- SSIS
- Data Engineering
- Dataform
- Datamodellering
- Kimball
- Datalager
- SSAS
- Power BI
- SSAS Tabular
- SQL
- Python
- Python PySpark
- Data Governance
- RBAC
- Unity Catalog
- Azure AI Foundry
- AI-agenter
- CI/CD
- GitHub
- Azure DevOps
- Scrum
- Agil projektledning
- Projektledning
- Kravanalys
- Dokumentation
- Verksamhetsanalys
- Finansiell rapportering
- General ledger
- IFRS9
- Lotus Notes
- OpenText
- Salesforce
- Google Cloud Platform
- Databricks
- Azure Databricks
- SSIS
- Data Engineering
- Dataform
- Datamodellering
- Kimball
- Datalager
- SSAS
- Power BI
- SSAS Tabular
- SQL
- Python
- Python PySpark
- Data Governance
- RBAC
- Unity Catalog
- Azure AI Foundry
- AI-agenter
- CI/CD
- GitHub
- Azure DevOps
- Scrum
- Agil projektledning
- Projektledning
- Kravanalys
- Dokumentation
- Verksamhetsanalys
- Finansiell rapportering
- General ledger
- IFRS9
- Lotus Notes
- OpenText
- Salesforce
Kurser & certifieringar
- Utbildning i PythonAvega · 2019
- Analyzing and Visualizing Data with Power BIedX · 2017
- Introduction to R for Data ScienceedX · 2017
- Implementing Real-Time Analytics with Hadoop in Azure HDInsightedX · 2015
Uppdrag
Bertel O. Steen
apr. 2026 – nu
Data Engineer
Bertel O. Steen moderniserar sitt dataekosystem och vidareutvecklar en Databricks-baserad… dataplattform med fokus på skalbarhet, datakvalitet och tydlig styrning. Hany arbetar som senior Data Engineer och bidrar både hands-on i utvecklingen och i tekniska vägval kring arkitektur, datamodellering, prestanda och Data Governance.
- Utvecklar och optimerar datapipelines och transformationslogik i Databricks med Python, PySpark, dbt och SQL.
- Arbetar med plattformsnära Databricks-frågor såsom Spark, Delta Lake, clusters, prestanda och optimering.
- Bygger strukturerade och skalbara datamodeller enligt Lakehouse- och medallion-principer.
- Arbetar med Unity Catalog för behörighetsstyrning, metadata, lineage, dataägarskap och Data Governance.
- Utvecklar och använder Metric Views för att centralisera affärslogik, KPI:er och gemensamma definitioner av verksamhetsdata.
- Tillgängliggör kvalitetssäkrad data till Power BI för analys, uppföljning och rapportering.
- Bidrar till arkitektur, tekniska designbeslut, kodstandarder och arbetssätt för att skapa en robust och långsiktigt förvaltningsbar dataplattform.
Resultat: Arbetet bidrar till en modern och skalbar Databricks-plattform med tydligare datastyrning, enhetligare KPI-definitioner och förbättrade förutsättningar för analys och rapportering. Plattformen skapar samtidigt en stabil grund för fortsatt utveckling och modernisering av dataekosystemet.
Visa merVisa mindre
- SQL
- Git
- Power BI
- Apache Spark
- Data Quality
- Data Governance
- Python PySpark
- Python
- Databricks
- Dbt
- Delta Lake
- Unity Catalog
- Medallion architecture
- CI/CD processes
- Lakehouse
Green Cargo
mars 2023 – apr. 2026
Data Engineer / Tech Lead
Green Cargo kör hållbara järnvägstransporter för gods i Norden, där små marginaler kräver hög… precision i dataanalys och uppföljning.
Hany etablerade en modern dataplattform från grunden genom att leda implementationen av Azure Databricks och skapa en robust Lakehouse-arkitektur. Utmaningen bestod i att kombinera kostnadseffektiv skalbarhet, avancerad datatransformation och ett styrt data-ekosystem samtidigt som två parallella migreringsspår hanterades: dels från äldre SSIS- och SQL-lager, dels från GCP-miljön med Dataform, BigQuery och Looker, som behövde byggas om till en sammanhängande Databricks-, dbt- och Power BI-baserad lösning.
- Tog rollen som Lead Data Engineer och lösningsarkitekt och definierade den tekniska målarkitekturen för Azure Databricks, inklusive klusterstrategier, kostnadsoptimering och detaljerad Lakehouse-struktur med medallion-principer.
- Säkerställde datastyrning genom Unity Catalog med tydliga principer för dataägarskap, åtkomstkontroll, kvalitet och spårbarhet på tvärs av både befintliga Azure-resurser och inkommande GCP-datakällor.
- Etablerade komplett CI/CD‑strategi och produktionssättning av Databricks‑arbetsflöden, inkluderande automatiserade tester, dbt‑orkestrering, kontrollerad deployment av pipelines samt strukturerad datamodellering enligt Kimball‑principer för enhetliga och lättanvända datamodeller.
- Byggde transformationslager i dbt med fokus på robusta modeller, hög kodkvalitet och skalbarhet, även som ersättning för tidigare Dataform-flöden i GCP.
- Migrerade och moderniserade både SSIS-paket och BigQuery/Looker-baserade lösningar till en enhetlig Databricks- och Power BI-arkitektur med förbättrad prestanda, tydligare datastruktur och reducerade driftkostnader.
- Utvärderade Snowflake och AWS som alternativ för dataplattformen.
- Dokumenterade datamodeller och dataflöden i Blue Dolphin.
Resultat: Den nya plattformen möjliggjorde snabbare leverans av dataprodukter, kraftigt förenklad dataförvaltning och lägre totalkostnad. Migreringen från både SSIS och GCP skapade ett mer enhetligt analytics-landskap med högre tillit till KPI:er, tydligare styrning och minskat manuellt arbete. Moderniseringen av transformationslogik och governance gav en mer förvaltningsbar och framtidssäkrad arkitektur, byggd för skalning och fortsatt innovation.
Visa merVisa mindre
- SQL
- AWS
- Continuous Integration
- Azure
- GitHub
- Metadata Management
- Power BI
- SSIS
- DAX
- Data Governance
- Azure Data Factory
- Python PySpark
- Python
- Google Cloud Platform
- Azure DevOps
- Snowflake
- Data Transformation
- Data Engineering
- Looker
- Power BI Premium
- Dbt
- Dataform
- Scrum
- Delta Lake
- Lakehouse Architecture
- Delta Live Tables
- Unity Catalog
- Tech leadership
- Azure/Databricks
- CI/CD processes
- Semantiska modeller
- Google Cloud Platform (BigQuery)
Vattenfall
jan. 2020 – dec. 2023
Data Engineer
Vattenfall är ett av Europas ledande energibolag där korrekt, spårbarhet och säker data är avgörande… för styrning av processer och finansiell uppföljning i stor skala.
Hany utvecklade datalager och rapportering för nätanslutningsprocesser samt uppföljning av underleverantörsavtal. Fokus låg på att skala datamodeller och pipelines samtidigt som definitioner, datakvalitet och åtkomst standardiserades över flera intressenter.
- Samlade krav och definierade KPI:er tillsammans med verksamheten och operationaliserade dessa i Kimball-baserade datamodeller i SQL Server/Azure Synapse.
- Utvecklade och orkestrerade datapipelines i Azure Databricks och Synapse, med inbyggd validering och avstämningar för att säkerställa tillförlitliga mått och minska felrisk.
- Byggde Power BI-rapporter baserade på semantiska modeller och DAX samt skapade återanvändbara mått som minskade dubbelkodning mellan team.
- Bidrog med lösningsförslag och etablerade governance-principer för datadefinitioner, en enkel metadatastruktur och åtkomststyrning för säker datadelning.
- Etablerade ett CI/CD-grundflöde i Azure DevOps/GitHub (versionering, pull requests, validering och releaseprocess) för dataartefakter i Scrum-team.
Resultat: Förbättrad aktualitet och kvalitet i rapporteringen samt mer konsekvent uppföljning genom tydligare definitioner och semantiska byggblock. CI/CD-processen minskade friktion i releaser och reducerade risken för fel vid förändringar i datakedjan.
Visa merVisa mindre
- ETL
- Microsoft SQL Server
- Continuous Integration
- GitHub
- Power BI
- DAX
- JIRA
- Kimball-metoden
- Data Governance
- Python
- Azure DevOps
- Scrum
- Azure Synapse
- Azure/Databricks
- CI/CD processes
- Semantiska modeller
- Åtkomststyrning
Vattenfall
jan. 2019 – dec. 2020
Data Engineer
Vattenfall är ett av Nordens största energibolag med behov av att kombinera data över affärsområden… för analys, styrning och stegvis modernisering till molnet.
Teamet utvecklade datalager och rapportering både on-prem och i molnet, där uppgiften var att möjliggöra nya analyser och genomföra migrering till Azure för verksamheter inom Värme och Finans med bibehållen datakvalitet.
- Integrerade data från flera källsystem och byggde DW-strukturer i SQL Server med datakvalitetskontroller och avstämningspunkter.
- Implementerade molnkomponenter i Azure Databricks och Azure Data Factory för att modernisera pipelines och minska teknisk skuld.
- Utvecklade Power BI-underlag för finansiell rapportering och General Ledger-analys med fokus på återanvändbara mått.
- Etablerade grundprinciper för åtkomst och spårbarhet mellan råzon och konsumtion för säkrare delning och enklare felsökning.
Resultat: Skapade stabila underlag för verksamhetsrapporter och bredare analys över affärsområden; migreringsstegen till Azure förbättrade skalbarhet och förenklade fortsatt modernisering utan att tappa kontroll på kvalitet och definitioner.
Visa merVisa mindre
- ETL
- Microsoft SQL Server
- DevOps
- Power BI
- Azure Data Factory
- Datamodellering
- Scrum
- Azure Synapse
- Azure/Databricks
H&M
jan. 2018 – dec. 2019
Data Engineer / Solution Architect
H&M Group är ett globalt mode- och detaljhandelsföretag där finansiell transparens och enhetliga… definitioner krävs för styrning över varumärken, marknader och tusentals användare.
Hany utvecklade målarkitektur och rapportplattform för controlling, där utmaningen var att bygga ett datalager från grunden och etablera ett semantiskt lager, governance och åtkomst som fungerar i stor skala.
- Arkitekturerade och utvecklade datalagret i Azure (Azure SQL/Azure Data Warehouse) samt pipelines i Azure Data Factory för standardiserad och skalbar datainläsning.
- Designade Kimball-baserade datamodeller och etablerade ett semantiskt lager för konsekventa KPI-definitioner och återanvändning i Power BI.
- Optimerade DAX och rapportmönster för drill-down till butiksnivå och stabil prestanda vid bred distribution.
- Etablerade ramar för governance i rapporteringslagret: definitioner, ägarskap och en enkel metadatastruktur som ökade spårbarhet och möjliggjorde mer self-service.
- Utvärderade nästa steg mot en modern plattform (inkl. Fabric-inriktning) genom principer för dataprodukter och tydligare konsumtionslager.
Resultat: Levererade ett robust beslutsstöd i stor skala där KPI:er blev mer konsekventa och enklare att tolka. Governance-ramar och semantiska byggblock minskade dubbelarbete och ökade återanvändning, samtidigt som en Fabric-nära riktning gjorde plattformen mer framtidssäkrad.
Visa merVisa mindre
- ETL
- Governance
- Fabric
- Power BI
- DAX
- Kimball-metoden
- Azure SQL
- Azure Data Lake
- Azure Data Factory
- Metadata
- Finansiell rapportering
- Datamodellering
- Azure Data Warehouse
- Semantiska modeller
Swedish Orphan Biovitrum
jan. 2018 – dec. 2018
Data Engineer / Solution Architect
Sobi är specialiserat på behandlingar för sällsynta sjukdomar och har en snabbt växande verksamhet… där planering, budget och analys kräver tillförlitliga data och tydliga definitioner.
Hany utvecklade arkitektur och DW-lösning för att förbättra budgetering, planering och analytics, där utmaningen var att snabbt etablera struktur, datakvalitet och styrning i informationsförsörjningen.
- Designade arkitektur och Kimball-baserade datamodeller för finansiell styrning och planeringsdata i Azure Data Warehouse.
- Implementerade ETL-flöden i Azure Data Factory och SQL med inbyggda valideringar som säkerställde korrekta mått och avstämningsbara siffror.
- Utvecklade Power BI-rapporter med semantiska modeller för budget, prognos och uppföljning med tydliga KPI-definitioner.
- Etablerade grundläggande governance: definitioner, dataägarskap och en enkel metadatastruktur samt principer för åtkomst till rapporteringslagret.
Resultat: Förbättrad informationsförsörjning och starkare beslutsunderlag för planering och budgetprocesser. Tydligare definitioner och kvalitetssignaler minskade manuellt arbete och ökade tilliten till uppföljningen i en växande organisation.
Visa merVisa mindre
- ETL
- SQL
- SSAS
- Requirements Gathering
- Power BI
- Kimball-metoden
- Azure Data Factory
- Finansiell rapportering
- Azure Data Warehouse
Coop / MedMera Bank
jan. 2017 – dec. 2017
Data Engineer / BI-konsult
Coop är en av Sveriges största dagligvaruaktörer där datadriven kampanjstyrning och riskkontroll är… avgörande för lojalitet, marginaler och kreditbeslut i stor kundvolym.
Hany arbetade med kund- och kreditdata för kampanjoptimering och riskanalys, där utmaningen var att bygga stabila dataflöden och analysunderlag över flera datakällor i en miljö som successivt moderniserades mot Azure.
- Designade och utvecklade datamodeller samt DW-strukturer för kund-, kampanj- och kreditdata med fokus på datakvalitet och spårbarhet.
- Utvecklade och förvaltade ETL-pipelines i SQL för integration av flera datakällor och säkerställde konsistenta och avstämningsbara data för analys.
- Implementerade datavalideringar och kvalitetskontroller i pipelines för att förbättra tillförlitligheten i kampanj- och riskdata.
- Samverkade nära verksamheten och BA för att operationalisera KPI:er och säkerställa att datamodeller stödde analys och segmentering.
- Bidrog till migreringssteg mot Azure genom att anpassa pipelines och datamodeller för bättre skalbarhet och framtida modernisering.
Resultat: Stabilare dataflöden och mer tillförlitliga analysunderlag för kampanj- och riskanalys. Förbättrad datakvalitet och mer strukturerad informationsförsörjning ökade hastigheten i analys och uppföljning samt minskade manuella moment i kampanjprocessen.
Visa merVisa mindre
- Datalager
- ETL
- SQL
- Kravanalys
- Azure
- Segmentering
- Kreditriskanalys
- Kampanjanalys
Volkswagen Financial Services
jan. 2015 – dec. 2016
Data Engineer / BI-konsult
Volkswagen Financial Services är en stor aktör inom fordonsfinansiering där regulatorisk… rapportering och riskstyrning är affärskritisk och kräver spårbarhet, kvalitet och kontroller i hela datakedjan.
Teamet implementerade regulatoriska ramverk (AnaCredit, IFRS9) och utvecklade datalager samt rapporteringsstöd, där utmaningen var att omsätta komplexa regelverk till validerade dataprodukter och robusta leveranser mot ECB.
- Tolkade regelverk och genomförde kravanalys för AnaCredit/IFRS9 samt översatte dessa till Kimball-baserade datamodeller i datalagret med fokus på spårbarhet och regulatorisk rapportering.
- Designade och utvecklade datapipelines och backend i Azure Data Warehouse med SQL och Python för automation, validering och kontrollregler, inklusive stored procedures och datakontroller.
- Implementerade rapporteringslager och analysunderlag i Power BI för portföljrisk, PD-scoring och rating med transparent och reproducerbar beräkningslogik.
- Etablerade kontroller för datakvalitet, data lineage och spårbarhet i rapporteringskedjan genom valideringar, avstämningar och dokumenterade definitioner.
Resultat: Möjliggjorde tillförlitliga och revisionsbara leveranser av regulatorisk data till ECB. Tydliga datamodeller, kontroller och spårbar logik ökade kvaliteten i rapporteringskedjan och minskade risken för fel i regulatorisk rapportering.
Visa merVisa mindre
- ETL
- SQL
- Kravanalys
- Power BI
- Stored procedures
- Datakvalitet
- Kimball-metoden
- Python
- IFRS9
- AnaCredit
- Azure Data Warehouse
Telenor
jan. 2015 – dec. 2016
BI-konsult
Telenor är en stor nordisk teleoperatör där SLA-styrning och leverantörsuppföljning kräver tydliga… KPI:er, transparent logik och pålitlig rapportering för flera verksamhetsdelar.
Teamet tog fram analyser och rapporter för SLA-uppföljning, där utmaningen var att bygga korrekta beräkningar för bonus/straff och göra data begriplig och återanvändbar över avdelningar.
- Samlade krav och definierade SLA-KPI:er med flera beställargrupper och dokumenterade beräkningslogik i kravspecifikationer.
- Implementerade datalagerlogik i SQL och SSIS med återanvändbara beräkningskomponenter (stored procedures) för konsistens.
- Byggde rapporter i SSRS och kompletterande visualisering i Power BI där det gav snabbare insikter och enklare konsumtion.
- Förvaltade semantiskt lager i SSAS, inklusive kuber, för gemensamma mått och dimensioner i rapporteringen.
Resultat: Gav bättre kontroll över SLA-utfall och mer konsekvent uppföljning av partners; standardiserade beräkningar minskade manuellt arbete och ökade transparens i leveransstyrningen.
Visa merVisa mindre
- SQL
- SSAS
- Requirements Gathering
- Power BI
- Stored procedures
- SSIS
- SSRS
- Kuber
- SLA monitoring
- Data Warehouse Development
- KPI-design
Stockholms stads bostadsförmedling (SSBF)
jan. 2015 – dec. 2016
BI-konsult
Stockholms stads bostadsförmedling är en central offentlig aktör där korrekt statistik och… transparent rapportering är avgörande för offentlig insyn och faktabaserade beslut.
Teamet säkrade och förbättrade datalagerprocesser för offentliga rapporter, där utmaningen var att höja datakvalitet och modernisera rapportering från SSRS till Power BI utan att tappa kontroll på definitioner och kvalitet.
- Kartlade datakällor och ETL-flöden i SQL/SSIS för att identifiera och åtgärda datakvalitetsbrister och inkonsekventa mått.
- Förbättrade datamodellering och semantiskt lager i SSAS (inkl. kuber) för mer tillförlitliga dimensioner och beräkningar.
- Migrerade rapporter från SSRS till Power BI med fokus på prestanda, tydlighet och återanvändbara mått.
- Etablerade rutiner för förvaltning och kvalitetskontroll (enkel governance) för att hålla rapporter stabila över tid.
Resultat: Höjde tillförlitligheten i datalager och förbättrade kvaliteten i offentliga rapporter; minskad felrisk och tydligare definitioner gjorde analysunderlag mer robusta för både interna och externa intressenter.
Visa merVisa mindre
- ETL
- SQL
- SSAS
- Power BI
- SSIS
- SSRS
- Kuber
- Förvaltning
- Datamodellering
- Scrum
Euromaint AB
jan. 2014 – dec. 2015
ERP-konsult / Analytiker
Euromaint arbetar med underhåll och service för spårbunden trafik där effektiv verkstadsstyrning och… mätbar förbättring är centralt för kostnad och leveransprecision.
Teamet mätte KPI:er och stödde budget/prognos samt anpassade affärssystemet för att stödja lean-inspirerade arbetssätt, där utmaningen var att koppla process, systemkonfiguration och uppföljning till konkreta förbättringar.
- Tog fram KPI-ramverk och byggde uppföljning i SQL Server med stored procedures för stabil rapportering och återanvändbara beräkningar.
- Konfigurerade Infor LN för att stödja Rail Production System (RPS) och standardiserade arbetsflöden i verksamheten.
- Byggde analysunderlag för budget och prognos samt etablerade avstämningsrutiner för kvalitet i data och rapporter.
- Visualiserade effekter av processförändringar och stöttade verksamheten med beslutsunderlag för prioriteringar.
Resultat: Bidrog till sänkta löpande kostnader och bättre styrning av verkstadsprocesser; tydligare KPI:er och mer konsekvent uppföljning ökade förutsägbarhet och förbättrade resursutnyttjande.
Visa merVisa mindre
- Microsoft SQL Server
- Lean
- Budget
- Stored procedures
- Infor LN
- Processuppföljning
- KPI-design
GE Healthcare
jan. 2013 – dec. 2014
BI-projektledare
GE Healthcare är ett globalt medicinteknikföretag där finansiell styrning kräver standardiserade… rapporter och tillförlitliga datakällor för att minska manuellt analysarbete.
Teamet standardiserade finansiell analys och rapportering, där utmaningen var att automatisera manuella moment och etablera en BI-lösning som gav konsekventa definitioner och snabbare rapportframtagning.
- Drev införande av BI-plattform (Oracle BI) och koordinerade krav, leverans och förändringsarbete med intressenter och ekonomifunktion.
- Standardiserade finansiella definitioner och rapportstrukturer för jämförbarhet och styrning, inklusive avstämningsbara mått.
- Integrerade datakällor i data warehousing-lösning och säkrade kvalitet via kontrollpunkter och valideringar.
- Arbetade iterativt i agil projektledning för att prioritera värde, hantera risker och få snabb adoption i organisationen.
Resultat: Automatiserade rapportgenerering och frigjorde betydande analystid; standardisering av definitioner gav mer jämförbara rapporter och förbättrade beslut genom ökad tillit till siffror och minskad manuell hantering.
Visa merVisa mindre
- Datalager
- Kravhantering
- Oracle Business Intelligence
- SQL
- Agil projektledning
- Hyperion Planning
- IBM Cognos
GE Healthcare
jan. 2013 – dec. 2013
Projektledare
GE Healthcare är en av världens stora medicinteknikkoncerner, där modernisering av… applikationsportföljer är centralt för att reducera kostnader, licensrisk och förvaltningsbörda.
Teamet planerade och genomförde pensionering av Lotus Notes-applikationer, där utmaningen var att migrera snabbt med kontroll på licenser, prioritering och beroenden mellan verksamhet och IT.
- Tog fram projektplan och roadmap för avveckling, inklusive prioritering i backlog och krav i user stories.
- Samordnade migrering till nya lösningar (t.ex. Salesforce/OpenText) och hanterade beroenden mellan team, applikationsägare och leverantörer.
- Analyserade licensstruktur och kostnadsdrivare samt stöttade upphandling och beslutsunderlag för moderna plattformar.
- Levererade delmål i korta cykler och rapporterade status, risker och effekter till styrgrupp och intressenter.
Resultat: Migrerade en stor del av applikationsportföljen på kort tid och reducerade licenskostnader; modernare plattformar och tydligare styrning minskade förvaltningsrisk och ökade skalbarhet för fortsatt digitalisering.
Visa merVisa mindre
- Projektledning
- Lotus Notes
- Product backlog
- User Stories
- OpenText
- Salesforce
- Leverantörsstyrning
- CRM
Utbildning
Civilingenjör Industriell Ekonomi
2007 – 2012
Kungliga Tekniska Högskolan (KTH)
Ekonomikurser med fokus på Kina
2011
Fudan University
Fristående kurser i Kinesiska och Miljöteknik
2010
Dalian University of Technology
Self Leadership Course
2010
KTH / Handelshögskolan i Stockholm
Liknande profiler
Kompetens · nivå och år
Dataplattformar och moln
- Google Cloud Platform
- Databricks
- Azure
- Azure Data Lake
- Delta Lake
- Azure Synapse
- Azure Data Warehouse
- Azure Databricks
- SQL Server
- HDInsight
- Azure SQL
- Snowflake
- AWS
- Fabric
- Hadoop
- BigQuery
Datapipelines och ETL
- SSIS
- Data Engineering
- Dataform
- ETL
- Azure Data Factory
- Data Pipelines
- Streaming
- Matillion
- Dbt
- Delta Live Tables
- Event Hub
- Informatica Power Center
- Data Transformation
Dataarkitektur och modellering
- Datamodellering
- Datalager
- Kimball
- Data Vault
- Reverse Engineering
- Dataarkitektur
- Datalake
- Data mesh
- Medallion architecture
- SCD Type 1/2/3
- Lakehouse Architecture
- Data Warehouse Development
BI och rapportering
- SSAS
- Power BI
- SSAS Tabular
- Looker
- Excel business intelligence
- DAX
- SSRS
- Oracle Business Intelligence
- Oracle BI
- IBM Cognos
- Segmentering
- Power BI Premium
- Semantiska modeller
- Kampanjanalys
- KPI-design
Språk och ramverk
- SQL
- Python
- Python PySpark
- Stored procedures
- Apache Spark
- SparkSQL
- R
- Java-programmering
Datastyrning och metadata
- Data Governance
- RBAC
- Unity Catalog
- Governance
- Metadata Management
- Metadata
- Datakatalogisering
AI och maskininlärning
- Azure AI Foundry
- AI-agenter
DevOps och CI/CD
- Git
- CI/CD
- GitHub
- Azure DevOps
- Testautomation
- TFS versionshantering
- DevOps
- JIRA
- SLA monitoring
- CI/CD processes
Ledarskap och arbetssätt
- Agil projektledning
- Scrum
- Projektledning
- Tech leadership
Krav och analys
- Kravanalys
- Dokumentation
- Verksamhetsanalys
- Requirements Gathering
- Product backlog
Finansiell rapportering och risk
- Finansiell rapportering
- General ledger
- IFRS9
- AnaCredit
- Hyperion Planning
- Kreditriskanalys
Produkter och system
- Lotus Notes
- OpenText
- Salesforce
- Infor LN
- Blue Dolphin
- CRM
Den som känner Hany
Theodor Wahlgren
Theodor är Hanys kontaktperson på Kvadrat.